M5 Max显卡实测:24GB显存拖后腿,性能比RTX 5090快7倍
2026-08-21 12:04:07
8月21日消息,据博主Alex Ziskind测试数据,英伟达RTX 5090移动版在与苹果M5 Max的本地AI性能对比中,中小模型场景的算力优势最高可达133%——但受限于显存容量,在超大模型、超长上下文测试条件下被M5 Max完成反超。
此次测试使用了最新的雷蛇灵刃18笔记本,其搭载的RTX 5090拥有24GB显存,在运行Gemma 4 12B、Qwen3.5 27B等主流规模的本地大模型时,RTX 5090无论是提示词处理速度还是文本生成速度,都大幅领先M5 Max。
实测数据显示,在12B-35B规模模型下,Gemma 4 12B模型中RTX 5090跑出4110 tokens/sec,相较M5 Max的1762 tokens/sec领先133%。
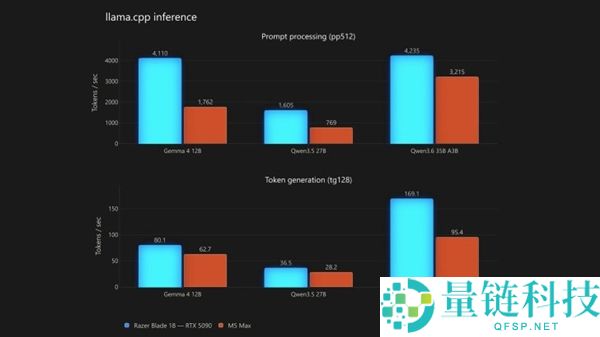
Qwen3.5 27B同样拉开109%的差距,即便到35B级别的Qwen3.6 35B A3B,RTX 5090依旧保有32%的提示词处理优势。
不过一旦进入超大模型、超长上下文这类高负载场景,测试结果就出现反转。
在Qwen3 4B模型的26万超长上下文测试中,RTX 5090的24GB显存瞬间告急,生成速度骤降至25.28 Token/秒。
反观拥有128GB统一内存的M5 Max,此时依然能稳定输出181.40 Token/秒,领先优势接近7倍。
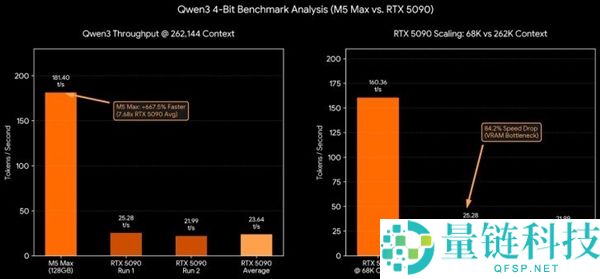
对比RTX 5090自身的两组测试更能直观看到显存带来的性能差距,在68K上下文条件下,显卡还可以跑出160.36 tokens/sec。
一旦上下文扩大到262144,受24GB显存上限约束,性能直接暴跌84.2%,吞吐量仅剩21-25 tokens/sec。
对于普通发烧友而言,如果你的AI应用侧重于高频短文本生成,RTX 5090依然是不二之选,但若涉及超长文档分析,显存容量的权重可能要排在算力之前。
 相关阅读
-
Vscode代码缩进怎么取消?Vscode代码缩进取消方法资讯百科 2026-09-07 13:34:08

-
比特币现金 2026 年价格预测:五月升级引入量子安全与智能合约,能否突破 850 美元?区块链快讯 2026-09-07 13:21:26

-
OPPO Find X10正式发布:全球首发3.2亿镜头,2023年最强影像旗舰金融科技前沿 2026-09-07 13:17:22

-
pycharm怎么设置代码对齐竖线?pycharm设置代码对齐竖线的方法资讯百科 2026-09-07 13:15:43

-
大批NS2用户遭误封现已解封,任天堂需承担责任金融科技前沿 2026-09-07 13:10:35

-
男人驾驶坦克300驶入网红湖泊拍照 官方已约谈教育整改金融科技前沿 2026-09-07 13:04:25

-
ALEO 币是什么?深度解析团队背景、融资机构、代币经济学及未来前景区块链快讯 2026-09-07 13:03:37

-
群联CEO潘健成:即使再建20座厂,NAND闪存需求依然不足,原厂缺口巨大金融科技前沿 2026-09-07 12:57:47

-
使用雷电模拟器卡顿怎么办?雷电模拟器卡顿的解决方法资讯百科 2026-09-07 12:57:13

-
微软确认优化Windows 11:8GB内存也能流畅运行,开机提速新体验金融科技前沿 2026-09-07 12:52:11


 热门资讯